皆さん、いよいよ医療統計学の無料大規模オンラインオープンコースが1月19日に始まります。 6週間のコースで、Rコマンダーを使ったハンズオン解析を実際にデータセットもお渡ししてインターアクティブに行える待望のコースです。 今のところ全て英語ですが、英語字幕も付き、ソフトの操作など比較的英語でもとっつきやすいと思いますので、お知り合いの方など、統計を学びたいという方入らっしゃいましたら是非お声掛けください!Edxを検索し、Osakaで検索していただくと、コース登録のEnroll Nowのリンクがでます。See you in the class!
コース紹介ビデオです。

(お申込み)http://osku.jp/c008
ご参加の際は、事前予約が必要ですので、10月14日(水曜日)までに以下のお申込みフォームからお手続き頂けますよう、お願い申し上げます。
**シンポジウム概要
大阪大学では、世界医学アカデミア標準電子データ集積システムREDCapを全学に導入し、様々な臨床・疫学研究で活用しております。REDCapシステムの国内での利用促進を目標に、開発元バンダービルト大学と密に協力し日本REDCapコンソーシウムを立ち上げました。本シンポジウムでは、米国バンダービルト大学から開発者を招き、安全にそして質の高い臨床研究を推進し、我が国の臨床研究の国際競争力を高めるために、REDCapシステムの有効な活用法について、意見交換を行います。
午前の部では、REDCapの実習形式のワークショップを実際に参加者が画面を構築しながら行います。午後のシンポジウムでは、REDCap事業責任者のポール・ハリス教授および開発責任者のロブ・テイラー氏を交えて、REDCap利用からみた臨床研究の世界の動向、バンダービルト大学での臨床研究の支援体制についてディスカッションするとともに、本学のREDCapグループ担当者より、我が国のREDCap導入状況や本学の運用体制・開発事例をご紹介いたします。阪大REDCapシステムの学外提供などについても、その利用方法や運用方法などもご紹介いたします。皆様どうぞ奮ってご参加ください。
【開催概要】
日時:2015年10月18日(日)10時00分~18時30分
場所:大阪大学吹田キャンパス
イノベーションセンター棟1階 マルチメディアホール
定員:120名(先着順、※事前申込要)
主催:大阪大学大学院医学系研究科臨床統計疫学寄附講座
共催:大阪大学附属病院未来医療開発部データセンター
新谷 歩/山本 景一

皆様お待たせいたしました。 R(パッケージMatchingとrms)を使った傾向スコアのプログラミングを紹介します。 ビデオでも言っておりますが、傾向スコアとは多くの交絡に対処するために行いますが、多くの交絡因子を重回帰モデルに入れると、一つの変数でも欠損のある人のデータは全て解析から外されます。 データの欠損により、解析集団に偏りがでて、結果の一般化が大変困難になります。 NEJMやJAMAでは、欠損データの補完を推奨しています。 傾向スコアを行う場合は欠損データは補完しましょう。このビデオではバンダービルト大学医療統計部部長のFrank Harrell先生が開発したrmsというパッケージを用いて傾向スコアを欠損値補完しながら作成し、またMachingパッケージを用い、Machingを自動で行います。 逆数重み法も最後に紹介しております。 この授業で用いたRコードを以下に示しております。 データセットも以下のコードをR上にコピペするだけで自動でバンダービルト大学のサイトから取れますので、是非試してみてください。
7月30日 傾向スコアコンセプト1
7月30日 傾向スコアコンセプト2
7月30日 傾向スコアRプログラム1(New!)
7月30日 傾向スコアRプログラム2 (New!)
英語ですみません、欠損値補完のコンセプトを紹介したビデオです。 ビデオここクリック
##授業で使ったRのコードです!##
library(rms)
library(Matching)
7月30日 傾向スコアコンセプト1
7月30日 傾向スコアコンセプト2
7月30日 傾向スコアRプログラム1(New!)
7月30日 傾向スコアRプログラム2 (New!)
英語ですみません、欠損値補完のコンセプトを紹介したビデオです。 ビデオここクリック
##授業で使ったRのコードです!##
library(rms)
library(Matching)
## Right heart cath dataset
rhc = read.csv("http://biostat.mc.vanderbilt.edu/wiki/pub/Main/DataSets/rhc.csv")
## The below is how you can read data into R from your local computer. Please set a location of your holder where you stored R dataset
#rhc = read.csv("C://Users//...//rhc.csv")
dd <- datadist(rhc)
options(datadist='dd')
## print first 6 rows
head(rhc)
## Show outcome (death) and exposure (swang1)
addmargins(table(rhc[,c("swang1", "death")]))
## Baseline table comparing covariates between exposure categories
s=summary(swang1~age+aps1+ sex + race + edu + income + chfhx+dementhx+psychhx+chrpulhx+renalhx+liverhx+gibledhx+malighx+immunhx+transhx+amihx , method="reverse", overall=TRUE, test=TRUE,data=rhc)
print(s)
print(s, prmsd=TRUE)
#################################################################################################################
# Conducting multiple imputation, without this, PS won't be created unless all variables have non-missing data
# Imputing missing data
#################################################################################################################
areg = aregImpute(swang1 ~ age+aps1+ sex + race + edu + income + chfhx+dementhx+psychhx+chrpulhx+renalhx+liverhx+gibledhx+malighx+immunhx+transhx+amihx, data=rhc, n.impute=5, x=TRUE)
fit.mi <- fit.mult.impute(swang1 ~ age + aps1+sex + race + edu + income + chfhx+dementhx+psychhx+chrpulhx+renalhx+liverhx+gibledhx+malighx+immunhx+transhx+amihx, lrm, areg, data=rhc)
#########################################################
# Creating linear predictor in lindner dataset
rhc$linear.ps <-fit.mi$linear.predictors
rhc$p=exp(rhc$linear.ps)/(1+exp(rhc$linear.ps))
#########################################################
par(mfrow=c(2,1))
hist(subset(rhc, swang1=='RHC')$linear.ps)
hist(subset(rhc, swang1=='No RHC')$linear.ps)
par(mfrow=c(2,1))
hist(subset(rhc, swang1=='RHC')$p)
hist(subset(rhc, swang1=='No RHC')$p)
#########################################################
## Match is a function in matching, this will do matching
#########################################################
rr1 = Match(Y = rhc$death, Tr = (rhc$swang1=='RHC'), X = rhc$linear.ps, M=1,caliper =0.1, ties=FALSE, replace = FALSE)
# matches 1 control to 1 exp
############################################################################
# The following will create a dataset which contains 1 row per patient
############################################################################
match.id =(rep(order(rr1$MatchLoopC[,1]),2))
id=rbind(matrix(rr1$MatchLoopC[,1], ncol=1), matrix(rr1$MatchLoopC[,2]))
match.id.data=data.frame(cbind(match.id,id))
names(match.id.data)=c("pair.id","idnew")
rhc$idnew=rhc$X
match.data<-merge(match.id.data, rhc, by="idnew")
######################################################################
######################################################################
######################################################################
# Create baseline patient characteristics table for the matched cohort
s=summary(swang1~p+age+aps1+ sex + race + edu + income + chfhx+dementhx+psychhx+chrpulhx+renalhx+liverhx+gibledhx+malighx+immunhx+transhx+amihx, method="reverse", overall=TRUE, test=TRUE,data=match.data)
print(s)
#####################################################################
# out put the data with soring by pair.id
# match.data[c("id", "pair.id", "linear.ps", "proc")][order(match.data$pair.id),]
head(match.data[order(match.data$pair.id),])
###################################################################################
# Checking distribution of propensity score within RHC and within No-RHC patients
par(mfrow=c(2,1))
hist(subset(match.data, swang1=='RHC')$p)
hist(subset(match.data, swang1=='No RHC')$p)
############################################################
# Set an environmental parameters for match.data dataset
dd <- datadist(match.data)
options(datadist='dd')
##############################################
# Unadjusted outcome analysis
out.unadj=lrm(death~swang1, data=rhc)
anova(out.unadj)
summary(out.unadj)
##############################################
# Adjusted outcome analysis
out.adj=lrm(death~swang1+age+aps1+ sex + race + edu + income + chfhx+dementhx+psychhx+chrpulhx+renalhx+liverhx+gibledhx+malighx+immunhx+transhx+amihx, data=rhc)
anova(out.adj)
summary(out.adj)
##############################################
# Outcome analysis using the matched data
out.match=lrm(death~swang1, data=match.data)
anova(out.match)
summary(out.match)
##############################################
# IPW
library(geepack)
# Creating IPW, prob of RHC for pt with RHC, prob of No-RHC for pt without RHC
rhc$ipw =ifelse(rhc$swang1=='RHC',1/(1-rhc$p),1/rhc$p)
#mean(as.numeric(rhc$ipw>6.26))
#truncating IPW at 95% tile value
rhc$ipw=ifelse(rhc$ipw>6.26,6.26,rhc$ipw)
#max(rhc$ipw)
###############################################################################################################################
# Need to use GEE to correct over-inflation of sample size, GEE requires to enter ID, so we are creating ID variable first
rhc$id=c(1:dim(rhc)[1])
# For GEE outcome needs to be a numerial value, so we now recode 1 and 0 for death
rhc$death.num <- with(rhc, ifelse(death == "Yes",1,0))
fit.ipw<-geese(death.num~swang1,
weights=rhc$ipw, id=id, data=rhc, mean.link="logit", family="binomial", corstr="ar1")
summary(fit.ipw)
このビデオではMMSEのような診断ツール開発のデータ解析に必要な統計手法(ROC, 感度、特異度、カッパ係数)などについて話しています。 ビデオここクリック
今日は皆さんにお願いです。 私がセンタ―長を務める阪大未来医療開発部データセンタ―で、研修目的でREDCapのアンケートを作成しました。 データの入力にご協力いただけましたら大変嬉しく存じます。 よろしくお願い申し上げます。
■ アンケート(第1弾)
1.花粉症とお味噌汁
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=LPH9JTFY3A
2.モニターと眼精疲労
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=839LLJDNH8
3.携帯電話
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=RNK9YMAYAX
4.同居者数と電話
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=AKKTKRXLX4
-----------------------------------------------------------------------
■ アンケート(第2弾)
「就寝30分前の行動と睡眠時間について」
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=4Y8YCJTEDW
中学受験結果と通塾開始時期
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=ETTY7HFP94
腸内環境とアレルギーの相関関係について
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=WNYWAPEW4X
「子供の教育と睡眠時間」
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=DNTF9JKJAD
■ アンケート(第1弾)
1.花粉症とお味噌汁
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=LPH9JTFY3A
2.モニターと眼精疲労
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=839LLJDNH8
3.携帯電話
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=RNK9YMAYAX
4.同居者数と電話
https://rdc01crf.dcc.med.osaka-u.ac.jp/redcap/surveys/?s=AKKTKRXLX4
-----------------------------------------------------------------------
修士課程プログラム (応募締切7月末)
阪大医学部、医科学修士、MPH(公衆衛生学修士)コースで、現在理数系大学の学部生、または、看護師など現在医学分野における学生及び社会人を対象に、修士プログラムを提供しております。 これらのプログラムを受講し、当教室の教員の指導の下、医学部における様々な臨床研究のデータ解析に携わりながら、将来医学分野で統計家として活躍を希望される方の育成を行っております。 MPHプログラムでは社会人入学も受け付けています。 興味ある方はstat-jimu@stat.med.osaka-u.ac.jp までご一報ください。ある特定の性質を持った患者さんに薬効が特に認められるなど(重篤な人には効くけれど
このビデオでは前向きのコホート研究、後ろ向きコホート研究など、認知症研究例を使いながら、疫学研究のデザインと解析についてお話します。
ビデオここクリック
今週阪大データセンタ―で、ランダム化のワークショップを行いました。 この後、REDCapチームの登録割り付け担当者からREDCapを用いた登録割り付けのレクチャーがありました。 REDCapを使った割り付けはVanderbilt時代も見たことがなかったので(封筒法で結構やってました)、かなり面白かったです。 ランダム化だけでも臨床研究は奥が深いな~と、改めて思いました。 REDCapのレクチャーは後日アップします。
ビデオリンク
ビデオリンク
EZRは無料ソフトRをより使いやすくRパッケージの一つであるRコマンダーのプラグ
ビデオここクリック
傾向スコアを用いた解析にはマッチング法、層別法、補正法、逆数重み法などがあります。 SPSSを用いた解析法を補正法、逆数重み法について説明します。 ただし補正法については最近はあまり推奨されていないのでできるだけ逆数重み法を用いるようにしてください。
傾向スコア補正法(英語)
SPSSによる逆数重み法(日本語)
ビデオを検索しやすくするために、ウェブサイトを新たに作りました。 日本語、英語ビデオの一覧がご覧いただけます。
大阪大学臨床統計疫学寄附講座ウェブサイトここクリック
GEE video
This video provides an instruction of using GEE to analyze repeatedly measured binary outcome data from a randomized controlled trial (RCT).
先週京都で行われました認知症関連の勉強会のビデオです。 疫学で重要なPECOや研究デザイン、RCT,前向きコホート、後ろ向きコホート研究について、論文で用いられた解析を紹介しながら、約55分駆け足で説明しております。
ビデオここクリック
ビデオここクリック
これは昨年夏Vanderbilt大学で行ったサマーコースのビデオです。 合計15時間第1回目は研究デザインです。 Case-control, Cohort, Cross-sectional Study や観察研究と無作為割り付け研究などについて話します。
ビデオここクリック
ビデオここクリック
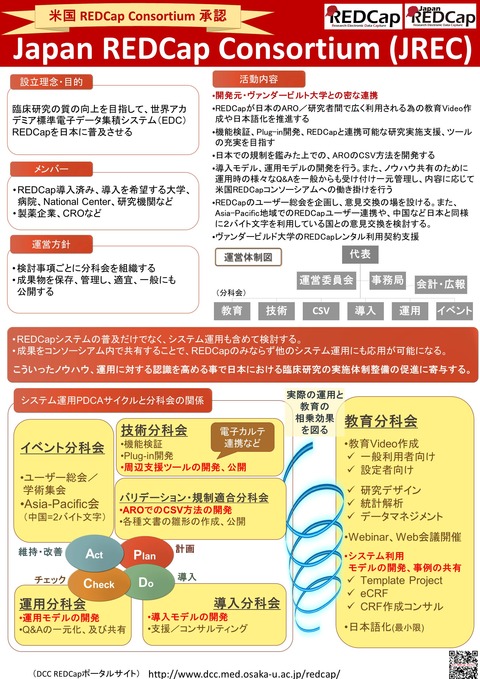
本日阪大で行われました国際シンポジウムで、Paul Harris先生から正式に認定をいただきました! REDCapに興味のある方、是非メーリングリストにご登録下さい。
Japan REDCap ポータルサイトここをクリック
阪大REDCap ポータルサイトここをクリック

Japan REDCap ポータルサイトここをクリック
阪大REDCap ポータルサイトここをクリック

【日時】:平成27年2月8日 (日) シンポジウム午後1時~4時 (4時から情報交換会:会費1000円当日徴収・軽食あり)
【場所】:大阪大学吹田キャンパス最先端イノベーション棟1階 マルチメディアホール
【定員】:120名
本シンポジウムでは、安全にそして質の高い臨床研究を推進し、国際的な競争力を強めるために必要な、情報システム基盤構築について米国Vanderbilt大学から研究者を招き意見交換を行います。
アカデミアデータセンターの情報基盤システム構築について、現在世界アカデミアで標準となった電子データ集積システムREDCap開発者Paul Harris氏を交えて日本REDCapコンソーシウムの設立・運営・展望についてディスカッションするとともに、電子カルテデータを臨床研究にリアルタイムで活用するシステムや被験者リクルートシステムなど米国NIHで支援・開発されVanderbilt大学で用いられている様々なデータ関連ツールなど情報基盤構築による米国NIHの現状と展望について紹介いただきます。
また、20万人のゲノムデータと、電子カルテデータを連結したシステムを持つ同大学ゲノムデータ統計解析センター長のYu Shyr氏より、オミクスや次世代シーケンスを含め、ゲノムデータを用いた臨床研究情報システムについて紹介頂きます。臨床試験・ゲノム疫学研究の推進のため日本医学アカデミアデータセンターのあり方について国内の研究者も交えアクティブなディスカッションの場を提供します。皆様のご参加をお待ちしております。
ご参加の際は、事前予約が必要ですので、来年1月15日(木曜日)までに添付の申込書にご記入の上、事務局宛へメールにてお申込み頂きます様、お願い申し上げます。
------------------------------------------------------------
主催:大阪大学大学院医学系研究科臨床統計疫学寄附講座
共催:大阪大学附属病院未来医療開発部データセンター
新谷 歩/山田 知美/山本 紘司
事務局:木 村/吉久保
TEL: 06-6210-8373
FAX : 06-6210-8374
E-mail: stat-symposium@stat.med.osaka-u.ac.jp
長らくお待たせしました。 傾向スコアのマッチングを無料統計ソフトEZRを使って行ってみましょう。 ビデオでは一つ前の観察研究のデータ解析のビデオの続きになりますので、そちらを見ていない人は是非そちらのビデオも見てくださいね。
ビデオここクリック
ビデオここクリック
SPSS、SAS、STATA、JMPなどさまざまな統計ソフトがありますが、高価であったり年ごとに更新が必要だったりとなかなか良いソフトに巡り会えませんね。 その中でもRは無料のソフトで私もこのブログで紹介していますが、高度なプログラム技術が必要だったりこれも専門家でなければ使いこなすのは難しいです。 Rコマンダー(Rcmdr)などRでも画面をクリックするだけで解析できる機能もあるにはありますが、設定の仕方が面倒だったり、カプランマイヤー曲線やコックスといった生存率解析析ができないなど、あちらを立てればこちらが立たず状態です。 最近Rコマンダーをより使いやすく進化させたプログラムを見つけました。私が試した無料ソフトの中では一番使い勝手が良く、日本語に対応しているのが大変嬉しいです。 そこで、早速EZRを使って生存率を新薬と既存薬で比べ、腫瘍サイズや年齢など交絡因子を補正する解析を、2x2分割表、ロジスティック解析、カプランマイヤー曲線、コックスを用いて解析してみましょう。
 データセットはここからダウンロードできます。
 EZR はここからダウンロード
EZRの使い方ビデオはこちら
データセットはここからダウンロードできます。EZR はここからダウンロードEZRの使い方ビデオはこちら
11月に京都で行いました講演会からのビデオです。 論文によく使われる統計量:平均や標準偏差、仮説検定とP値、信頼区間、オッズ比、リスク比、レート比の違いその使い方、症例数計算など数式を使わずに説明しています。 ビデオここクリック
阪大医学系研究科臨床統計疫学寄附講座主催、第2回臨床統計疫学セミナーは「今日から使える医療統計: 医学論文を紐解くための統計学」と題しまして、平均や標準偏差といった記述統計量、p値と仮説検定、信頼区間、症例数計算、オッズ比など医学論文に多発する統計用語について数式を用いず分かり易く説明します。
【第2回臨床統計疫学セミナー詳細】
日時: 2014年11月27日 (木) 17:30~19:00
場所: 吹田キャンパス
最先端医療イノベーションセンター棟 1階
マルチメディアホール
定員: 100名
主催: 医学系研究科 臨床統計疫学寄附講座
共催: 未来医療開発部 データセンター
参加費: 無料
参加登録:必要(mail)
Mail address: stat-seminar [at]
stat.med.osaka-u.ac.jp
※メールの送信時には、[at]を@に代えてください。メールの件名を「REDCap講習会参加」とし、メール本文にご所属、学年(または職位)、名前をご記入の上、上記メールアドレスへ送信ください。
※定員に達し次第、随時受付を締め切ります。当日席に余裕がある場合は、事前申し込みがなくても受講を受け付けます。
※応募者多数の場合はご希望に添いかねることもありますので予めご了承ください。
《お問い合わせ》 医学系研究科 臨床統計疫学寄附講座 (内線:8373) E-Mail:stat-seminar
[at]stat.med.osaka-u.ac.jp ※メールの送信時には、[at]を@に代えてください。
このたび、阪大医学系研究科 臨床統計疫学寄附講座で、臨床研究に携わる研究者に向けて、臨床研究データ集積管理システム、REDCapの利用講習会を開催します。 REDCapはITなどの専門家でなくとも簡単にウェブベースで構築、多施設のデータを簡単安全に集積できるシステムで、世界87か国1087施設で使用されており、アカデミック医学研究では世界標準になりつつある画期的な臨床研究支援ツールです。 阪大附属病院未来医療開発部データセンターにおいてREDCap運用サポートをいたしております。
阪大医学部ではVanderbilt大学とライセンス契約を結びましたので医学部所属の方々に使用していただくことが可能になりました。
阪大医学部外の方々にはヴァンダービルト大学のREDCapシステムを1プロジェクトひと月184ドルでレンタル契約可能となりました。
本講習会ではVanderbilt大学とのレンタル契約・REDCap運用のノウハウなどについても話します。 講習会はビデオ収録し後ほどアップしますので是非閲覧ください!
来年2月8日にはREDCap開発者Paul Harris 教授を招き国際シンポジウムを阪大で開催します。 そちらも是非ご参加ください。 (詳細は後日ポストします )
【REDCap講習会詳細】
日時: 2014年11月13日 (木) 17:30~19:00
場所: 吹田キャンパス
最先端医療イノベーションセンター棟 1階
マルチメディアホール
定員: 100名
主催: 医学系研究科 臨床統計疫学寄附講座
共催: 未来医療開発部 データセンター
プログラム:REDcap概要説明 新谷 歩 (臨床統計疫学寄附講座教授)
REDCap利用説明 未来医療開発部 データセンター REDCap 担当者
参加費: 無料
参加登録:必要(mail)
Mail address: stat-seminar [at] stat.med.osaka-u.ac.jp
※メールの送信時には、[at]を@に代えてください。メールの件名を「REDCap講習会参加」とし、メール本文にご所属、学年(または職位)、名前をご記入の上、上記メールアドレスへ送信ください。
※定員に達し次第、随時受付を締め切ります。当日席に余裕がある場合は、事前申し込みがなくても受講を受け付けます。
※応募者多数の場合はご希望に添いかねることもありますので予めご了承ください。
《お問い合わせ》 医学系研究科 臨床統計疫学寄附講座 (内線:8373) E-Mail:stat-seminar [at]stat.med.osaka-u.ac.jp ※メールの送信時には、[at]を@に代えてください。
Click here for a video
多くの皆様からリクエストいただいた傾向スコア(PS)によるマッチングソフトです。無料ソフトRをSPSSに読み込む方法でSPSS上でPSによるマッチングができます。 SPSSを既にお持ちの方は以下のステップで無料で設定できます。 そうで無い方は、少々難しいかもしれませんがRによるマッチング方法を次のビデオでご紹介しますので(個人的にはそちらの方がお勧めです)、もうしばらくお待ちください。 PSのマッチングビデオは日本語圏外の方々からも多くリクエストいただきましたので、今回は英語です。
Step 1. Install a version of R for you SPSS system. Different version of SPSS requires different version of R.
For SPSS Version 22, install R-2.15.0
For SPSS Version 21, install R-2.14.0.
Step 2. Go to the website below to download IBM SPSS Statistics-Essentials for R.
I installed "FP1 for Windows 64 bit"
https://www14.software.ibm.com/webapp/iwm/web/reg/download.do?source=swg-tspssp&lang=en_US&S_PKG=dl6&cp=UTF-8&dlmethod=http
Step 3. (this is just for checking, you can skip this step).
Steps 1 and 2 should create R-plug in already in SPSS,
To check R-plug in is working properly, go to SPSS syntax then type the next 4 lines and execute (If you don't have error message, that means OK).
BEGIN PROGRAM R.
x <- "R plug-in is working properly"
x
END PROGRAM.
Step 4. Download psmatching_2.spd from
http://sourceforge.net/projects/psmspss/files/psmatching2/psmatching_2.spd/download?use_mirror=cznic
Step 5. Go to SPSS, Utilities, Custom Dialogs, choose the file of Step 4 to bring into SPSS.
Step 6. You should be now seeing PS matching dialog box among other statistical dialogboxes.
Congratulations!!!
Congratulations!!!
6月2日にデータベースマネージメントコースがコーセラで受講開始します。 このコースでは主にAROの臨床研究ツールとして米国で開発されたデータベースシステムREDCap (Research Electronic Data Capture)の使い方及び一般的なデータベースマネージメントについて学ぶことができます。
コース詳細はここをクリック
コーセラ聴講はここをクリックして、名前とメールアドレスを登録するだけです。 登録後、開講の前日または当日にコーセラからメールでコースのウェブアドレスが送られてきますので、それをクリックすると、ビデオやクイズを閲覧できます。 講義終了までに登録すればビデオの閲覧はできますので、出遅れたと思わずに是非聴講してみてください。 ビデオは簡単にダウンロードも可能です。 毎週出る宿題をクリアすればコース修了書(Certification)がもらえます。
コース開催中のみAmazon Cloudで作られたREDCapの仮想サーバーにアクセス可能になります(これはあくまでも教育目的に作られているので、実際のプロジェクトのデータキャプチャーには使えません)。 実際のプロジェクトに用いたいのであれば、各施設がREDCapコンソーシウムに加盟し、ソフトの供給を受けたのち施設レベルでのシステム導入が必要となります。
REDCap仮想サーバーへのアクセスは以下の方法で行えます。
1. https://www.datacourse.org/ にアクセス
2. Login using Coursera をクリック
3. コーセラ登録がまだのかた、メールアドレス、パスワードを入れてコーセラに登録する。
4. コーセラ登録をすでに終えている方、First Name, Last Name, メールアドレスを設定しこのコースへの登録
5. 登録確認のメールが送られるので、メールを開けて指定のリンクをクリック
6. REDCapの画面が出たらセットアップ終了
2. Login using Coursera をクリック
3. コーセラ登録がまだのかた、メールアドレス、パスワードを入れてコーセラに登録する。
4. コーセラ登録をすでに終えている方、First Name, Last Name, メールアドレスを設定しこのコースへの登録
5. 登録確認のメールが送られるので、メールを開けて指定のリンクをクリック
6. REDCapの画面が出たらセットアップ終了
Journal of Prosthodontic Research で歯学研究者のための統計チェックリストを書かせていただきました。医学の分野でも勿論使える内容ばかりです、どうか皆さんの論文執筆にお役立て下さい。
欠損値補完法(英語)50分
どんなに完璧な臨床研究でも、前向きの観察研究でも欠損値には大いに泣かされます。 特にビッグデータなどレトロなデータは欠損値によって全く使い物にならないデータも少なくありません。 NEJMの統計査読者からも推奨されているMultiple Imputationやその他様々な欠損値補完法を紹介します。
How to Perform Multiple Imputation in SPSS (45分) ( 英語)
How to Perform EM single imputation in SPSS and testing MCAR (5分) (英語)
どんなに完璧な臨床研究でも、前向きの観察研究でも欠損値には大いに泣かされます。 特にビッグデータなどレトロなデータは欠損値によって全く使い物にならないデータも少なくありません。 NEJMの統計査読者からも推奨されているMultiple Imputationやその他様々な欠損値補完法を紹介します。
How to Perform Multiple Imputation in SPSS (45分) ( 英語)
How to Perform EM single imputation in SPSS and testing MCAR (5分) (英語)
Rのインストールの仕方、簡単な操作法、平均中央値など記述統計量、T検定、ノンパラメトリック検定、ログ変換後のT検定など、基本的なトピックを系統立てて学べるようにビデオを作っています。 どうぞご覧ください。全て英語です(また日本語も作りますね!)
Introduction to Biostatistics by Ayumi Shintani
1. Installing R (1:57)
2. Installing R Studio (4:20)
3. Introduction to R commander (1:31)
4. Reading datasets into R commander (6:26)
5. How to compute mean, SD, median and IQR in R commander (2:59)
6. Hot to enter data into a spreadsheet for statistical analysis (12:30)
7. Hypothesis testing and p-vaues (3:29)
8. Central Tendency; Mean, Median and Mode. (Khan Academy Video) (9:00)
9. Range, variance and standard deviation as measures of dispersion (Khan Academu Video)
10.Central Limit Theorem (Khan Academy Video)
11. Standard Errors (Khan Academy Video)
12. Interpretation of mean and SD, median and IQR (17:08)
13 Comparing difference between SD, SE and CI (5:34)
14. Confidence Interval(22:00)
15. T-test concept (14:56)
16. How to perform T-test with and without log-transformation in R commander (7:26)
17. T-test with log-transformation concept (7:47)
18.How to perform a T-test with log-transformed outcome variable
19. Non-parametric test (Wilcoxon rank-sum test) (7:39)
20.How to perform a non-parametric test comparing 2 medians
21. Comparing analytical power among t-test, Wilcoxon test, and t-test with log-transformation
22. Statistical Checklist for Nature Cell Biology (1) Statistical graphs (15:00)
23. Statistical Checklist for Nature Cell Biology (2) P-values (5:38)
24. Statistical Checklist for Nature Cell Biology (3) Correction for Multiple testing, Bonferroni (31:45)
25. Statistical Checklist for Nature Cell Biology (4) Selecting proper statistical tests (8:38)
26. Statistical Checklist for Nature Cell Biology (5) Repeated measures analysis, why needed (3:29)
以前にご紹介した、無料オンラインラーニングのコーセラで今日9月16日から無料オンラインデータベースREDCapシステムを作ったヴァンダービルトのPaul Harris教授の7週間にわたる”Data Management for Clinical Research”の講義が始まりました。 。聴講はここをクリックして、名前とメールアドレスを登録すれば、コーセラから登録Eメールにコースのウェブアドレスが送られてきますので、それをクリックするとビデオが閲覧できます。 是非ご覧ください!
Rコマンダーでロジスティック回帰モデル (ビデオここクリック)
 このビデオではRコマンダーを用いて、ロジスティック回帰モデルを使ってオッズ比を計算します。 モデルに共変量を入れる交絡因子の補正法も紹介しています。
 このビデオではRコマンダーを用いて、ロジスティック回帰モデルを使ってオッズ比を計算します。 モデルに共変量を入れる交絡因子の補正法も紹介しています。
 このビデオではRを用いて2x2テーブル(クロス集計表)を作成し、オッズ比を計算します。 またそのオッズ比に有意差があるかないかを調べるカイ二乗検定、フィッシャーの直接確率テストをRを用いて行います。
 オッズ比は死亡生存のように2値変数のアウトカムと研究要因の相関の強さを示すMeasure of Associationです。 例えばタバコを吸うと心筋梗塞のリスクが50%で吸わない人はその半分の25%だとします。 リスク比は50%割る25%で2となり、タバコを吸うとリスクが2倍になるといえます。 この場合のオッズ比は3となり、オッズ比から結果を論じると、喫煙で心筋梗塞のリスクが3倍になったという間違った結果を導いてしまいます。 臨床研究では2値変数のアウトカムではオッズ比を用いることが多く、リスク比を使うことは珍しいのです。 2値変数のアウトカムの解析に必ずと言っていいほど使われるロジスティック回帰モデルは結果はオッズ比を用いて表します。 理解しやすいリスク比ではなくオッズ比が臨床研究論文で多用されるのはどうしてでしょうか? このビデオではそのオッズ比の計算の仕方、Rを用いた計算の仕方、リスク比との違い、その使い方を説明します。
オッズ比の手計算の仕方(ビデオここをクリック)
オッズ比を身近な例で考える(ビデオここをクリック)
どうしてオッズ比が使われるのか(ビデオここをクリック)
オッズ比をリスク比に変換するエクセルプログラムはここからダウンロード
リスク比をオッズ比に変えるにはコントロール群(暴露のない群)でのイベント率が必要です。 たとえばイベント率が1%の時(稀なイベント)の時はオッズ比(OR)=10はリスク比(RR)=9とまあまあ近いですが、イベント率が50%の時OR=10 はRR=1.8 に相当します。 するとOR=10 をリスクが10倍と説明すると可なり間違った結果になりますね。 この様な間違いを防ぐために、ORをRRに変換してみましょう。 このプログラムでは、オッズ比とコントロール群のイベント率を入れると簡単にリスク比が計算できます。 このファイルはまずダウンロードしてからお使いください。(通常はORを説明するときにリスクという言葉を用いずオッズと説明すればこの様な変換はしなくともORを論文に使えます。このあたりは3つ目のビデオで説明していますのでご覧ください)
 このビデオでは無料統計ソフトRでT検定の方法、等分散の解析、ノンパラメトリック法であるウィルコクスンの順位和検定による解析法をお見せするほか、エクセルを用いたやり方も説明していますが、独立した2群の比較をする際エクセルをなぜ使わないほうが良いかについても話しています。
 このビデオでは、Rを使ってエクセルのデータを読み込み平均、標準偏差、中央値、四分位区間などの基本的な統計量を計算します。
 P値を計算するとき、コンピュータは片側と両側のp値を計算してきます。片側のp値は両側のp値の半分なので有意差が出やすいという理由から多くの人が片側を使っていると聞きました。 これは、殆どの医療研究ジャーナルでは認められていないのでやめてください。 このビデオではその理由を説明しています。
 この夏は5月の日本補綴学会の学術大会での招待講演、大阪大学歯学部、日本大学歯学部での講演と歯科分野での統計学についてお話しさせていただきました。 British Dental Journal (BDJ) の統計チェックリストから統計で欠かせないコンセプトについてご紹介しています。 記述統計量、グラフ書き方、交絡など今までのビデオでお届けしている内容もありますが、多重検定の補正、信頼区間を用いた同等性の解析例など、新しいトピックも盛りだくさんです。
 皆さんは統計ソフト何を使っていますか? 私は大学院ではSASを使ったのでSASが私の主言語ですが、最近は解析にはR,アカデミックな場での教育にはSPSSを使っています。 STATAも必要に応じて使っています。 SPSSは私のビデオでも紹介している通りエクセルのようにポイントクリックで操作が行えるのでとてもユーザーフレンドリーなソフトですが、1年でライセンスが切れるので毎年更新しなければなりません。 SASも1年ごとの更新ですが、その使用には多額な費用が掛かります。 STATAは1度きりの購入で確か数万円だったと思いますがSTATAのよいところは年毎のライセンス更新はなく古いバージョンでも半永久的に使えます。 Rは完全にオープンソースのソフトでその使用に一切費用はかかりません。 個人でパッケージのアップロードが行えるので、論文などに掲載された新しい手法もすぐにアップできるという利点があり、今ではアカデミックな統計解析の主流を行くといっても過言ではないでしょう。 そのRにはRコマンダー(Rcmdr)というエクセルのようなポイントクリックの機能があります。 これからRcmdrの使い方について説明していきますが今日はまずRをインスト‐ルしてみましょう。
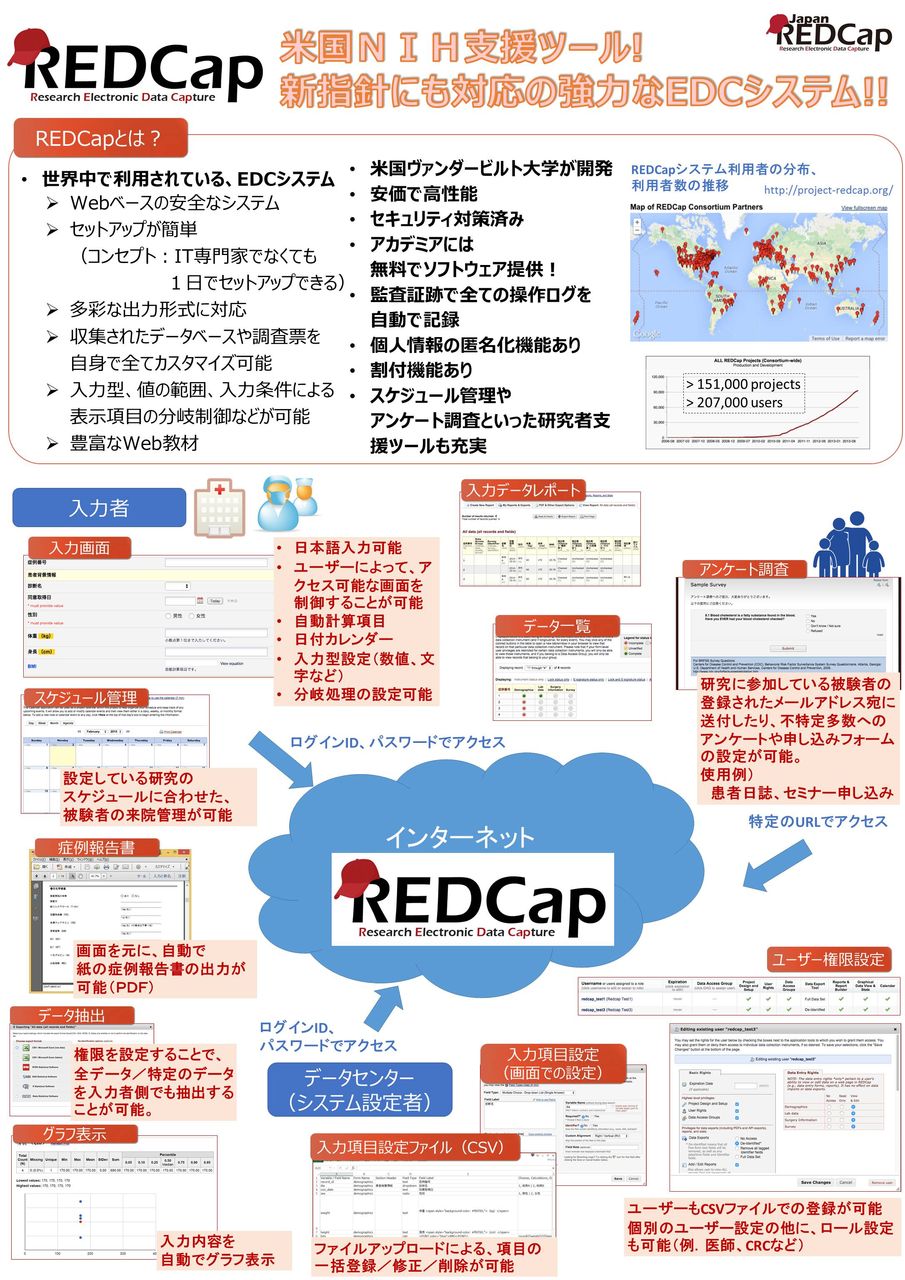
REDCapは臨床医、看護師などIT専門家でなくとも誰でも簡単にWeb上で構築管理できる、世界標準の安全性を備えたデータ収集システムで、私が14年間務めました米国ヴァンダービルト大学がNIHの支援によりCTSAのグラントの下(Clinical and Translational Science Award、 NIH臨床橋渡し研究支援グラント、米国62拠点病院、12億円/1施設1年)開発、アカデミアを中心にNPO施設に無料でソフトを配布し、世界で1200施設88か国、20万人が活用し、まさに世界アカデミアの標準ツールとして使用されており、中国でも21施設で使用、130プロジェクトが稼働しています。 大阪大学臨床統計疫学寄附講座では、日本REDCapコンソーシウムの活動を支援しております。 REDCapのデータ入力画面を見てみたい方はここをクリック(自由に入力下さい) 阪大附属病院未来医療開発部データセンタ―では、REDCapを用いたデータベースの構築支援、被験者登録・割り付けシステムの構築サービスも行っております。 ご興味のある方は是非ご一報ください。お問い合わせはここをクリック
ヴァンダービルト大学では年間587億円にも上る研究費で臨床、基礎研究を行っており、その研究を支えるデータシステムとして殆どのプロジェクトでREDCapが用いられています。 ヴァンダービルトの私の良き友人であるPaul Harris教授によって開発されました。 REDCapはオンラインベースのデータ入力が可能で、多施設臨床研究データをリアルタイムで管理、作成します。 REDCapは臨床研究に欠かせないさまざまな機能を可能にしたばかりではなく、そのユーザーフレンドリーなインターフェイスによってデータベースの経験がほとんどない人でも簡単に使いこなすことが出来ます。REDCapの使用形態には2通りあり、(1)Vanderbilt大学のシステムを使用(ASP)する方法と(2)Vanderbilt大学とEnd User Licence Agreement(EULA)契約をした契約者が自施設のサーバーに自前システムとして構築する方法があります。 (1)のASPは、現在日本のユーザーの皆様に対しては大阪大学のシステムを提供できるよう、年内開始を目指してVanderbilt大学と調整中です。 これを受けましてVanderbilt のASPは新たな契約は受け付けておりません。 大変申し訳ございませんが、日本のユーザーの皆様、もうしばらくお待ちください。 興味ある方はお名前とご連絡先をこちらまでお寄せください。阪大のシステムが使用可能になり次第お知らせいたします。 (2)のEULAで使用するサーバーは契約者が契約をした外部のクラウドサーバーでも構いません。 EULA締結後アカデミア及びNPOであればソフトウェアは全て無料でダウンロードできますが、企業などProfit OrganizationではEULAできません(研究代表者がNPOに所属している研究ではデータ入力などに限定された用途であれば企業でも使用できます)。
安価優良のデータシステムとしてREDCapは日本でも注目されているシステムです。 大附属病院未来医療開発部では10月から始まる人を対象とする疫学・臨床研究新指針の対応策の一つとして、阪大全学でのREDCapの使用をサポートしています。
日本語のREDCapのビデオリンクです。REDCapは阪大付属病院未来医療開発部データセンター、臨床統計疫学寄附講座で支援しております。
REDCap メーリングリストはこちらをクリック
REDCap紹介ビデオ (Paul Harris, 3 分)
REDCap機能説明ビデオ(計4本、日本語、阪大DCC)
阪大REDCap ポータルサイト (日本REDCapコンソーシウムウェブサイト)
REDCapの主な機能;
(1)Webベースデータキャプチャ
(2)臨床従事者など誰でも簡単にデータベース構築可能
(3)多施設での同時データ入力
(4)CRF, データディクショナリーの自動構築
(5)不特定多数を対象としたアンケート調査システム
(6)研究の進行状況が一目で分かる進行状況管理
(7)独自カレンダーを用いた研究スケジュール管理
(8)無作為自動割り付け(動的割り付けには対応しておりません)
(9)ダブルエントリーデータ入力チェック
(10)フル監査証跡
(11)リアルタイムなデータ入力エラー検出
(12)統計ソフトへの簡単なデータダウンロード
(13)研究スケジュールの管理
(14)ワンタッチで記述統計レポート作成
(15)電子カルテ、バイオバンクと連結可能(これは現在Vanderbiltでのみ実現されています)
(16)ワンタッチで世界基準(HIPAA)で個人情報の匿名化実現
(17)データ集積フォームのテンプレート共有
(18)電子署名
(19)アクセス権限コントロールによる中央データセンター機能
(20)標準業務手順書(SOP)などの文書管理システム
(21)MRIなどの高次元画像データの自動キャプチャ、長期保存管理
(22)豊富なE-ラーニング教材
(23)無料ヘルプデスク
(24)日本語を含む多言語対応
(25)PROMISなど200以上に及ぶ臨床アウトカム測定ツールの簡単ダウンロード
.
大阪大学臨床統計疫学寄附講座ウェブサイト
今後のセミナー予定
阪大大学病院先端医療イノベーション棟1階マルチメディアホール
6時00分~ (外部の方も参加できます)
臨床統計疫学概論B
第1日目 (8月27日)順序ロジスティック回帰モデル、ポアソン回帰モデル
第2日目 (9月10日)生存率解析 - カプランマイヤー曲線
第3日目 (9月24日)生存率解析 - コックス比例ハザード回帰モデル
第4日目 (10月8日)生存率解析 - 時間変動制コックス比例ハザード回帰モデル
第5日目 (10月22日) 無作為化臨床試験のデータ解析
第6日目 (11月12日)診断、予後予測を目的とした分析、ROC, 感度、特異度、NRI, IDI
第7日目 (11月26日)欠損データの解析
第8日目 (12月17日)リピートデータの解析、共分散分析
第9日目 (12月24日)リピートデータの解析、混合効果モデル
第10日目 (1月14日)一般化線形方程式
人気記事
記事検索
プロフィール

shintaak
作者プロフィール
新谷歩
現在、大阪大学大学院医学系研究科臨床統計疫学寄附講座教授。同大学病院未来医療開発部データセンター長兼任。米国エール大学で生物統計博士号及び公衆衛生学の修士号所得。 その後14年間Vanderbilt大学医学部医療統計部門で医療統計家として勤務。東海大学客員准教授、京都大学非常勤講師。NEJMやJAMAを含む医学ジャーナルに180篇。ヴァンダービルトでは臨床研究修士コースで10年間,若手医師サイエンティストの統計教育に深く携り,昨年ヴァンダービルト大学医学部でティーチングアワードを受賞。 医学書院発行の週刊医学界新聞で「今日から使える医療統計学」を昨年1年間連載し,そのユニークな統計教授法には定評がある。
アクセスカウンター
- 今日:
- 昨日:
- 累計:
統計を学びたいお友達にも是非教えてあげてくださいね。

